向量数据库里存了几百万条数据,每次查询都像在大海捞针,速度慢得让人想摔键盘。原因很简单——向量相似度搜索本质上是在高维空间里找最近的邻居,如果暴力比对每一条数据,计算量是 O(N),数据量一大就彻底扛不住。
所以我们需要索引,用一些巧妙的策略来减少需要计算的距离次数。今天来看几个最主流的索引类型:FLAT、IVF、HNSW 和 LSH。它们思路完全不同,各有各的特性,用对了能让查询快如闪电,用错了也可能让你怀疑人生。
Table of contents
Open Table of contents
FLAT:暴力搜索,精度满分但速度感人
FLAT 其实不算是一种“索引”,它就是把所有向量原封不动地存下来,老老实实拿查询向量和每一条数据算距离,然后排序返回最近的几个。没有任何预处理,没有任何近似。
优点和缺点都极其纯粹:
- 优点:精度 100%,因为就是暴力比对,不会漏掉任何一条。而且实现简单,不需要调任何参数。
- 缺点:速度 O(N),数据量一大就完全没法用。内存占用也高,因为要存全部原始向量。
所以 FLAT 只适合那种数据量很小(几万条以内)、对精度要求极其苛刻、查询频率也不高的场景。比如你刚搭了一个原型系统,数据还没多少,先用 FLAT 顶着;一旦数据规模上来,FLAT 就得退役了。
IVF:先把空间划分成小区,只搜最近的那几个
IVF 全称 Inverted File Index,倒排索引。思路很朴素:把整个向量空间划分成很多个小的区域(聚类),每个区域有一个中心点。查询的时候,先找到离查询向量最近的几个中心点,然后只在这些中心点对应的区域里搜索候选向量,其他的直接不看。
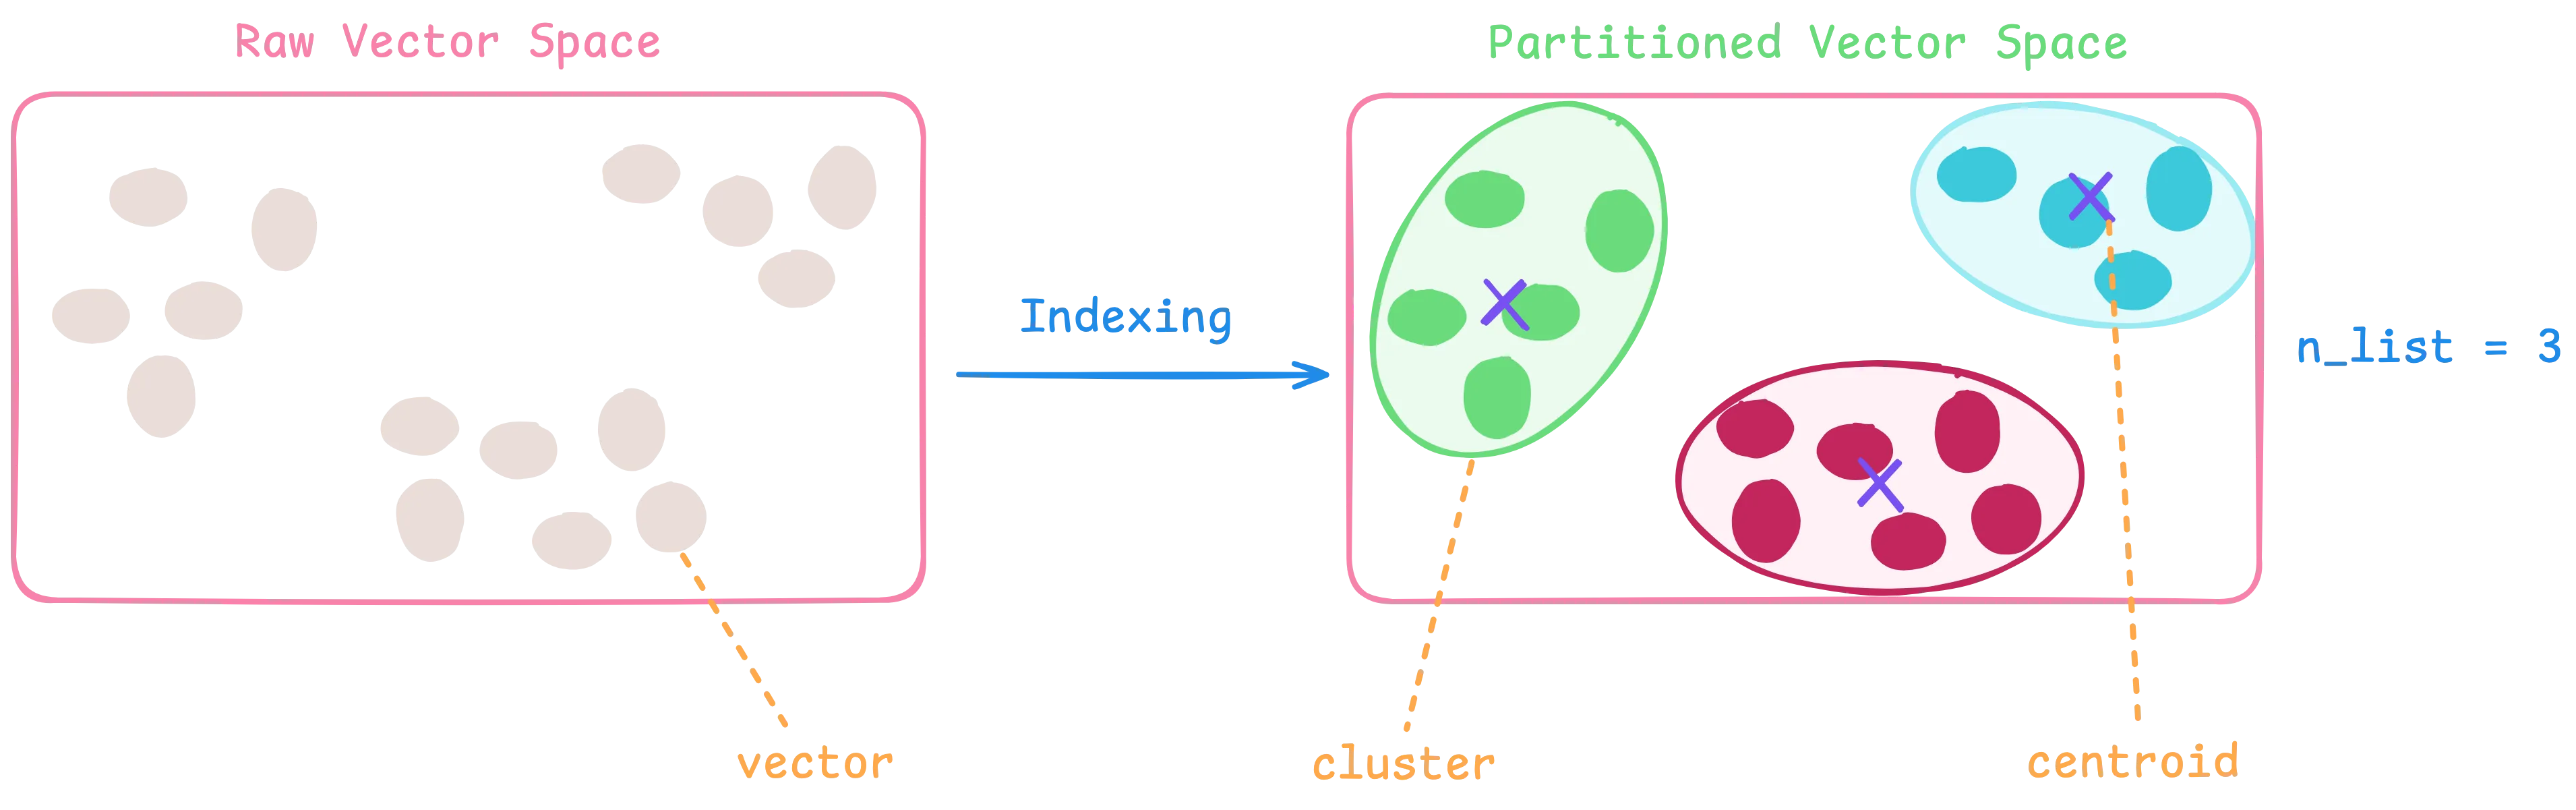
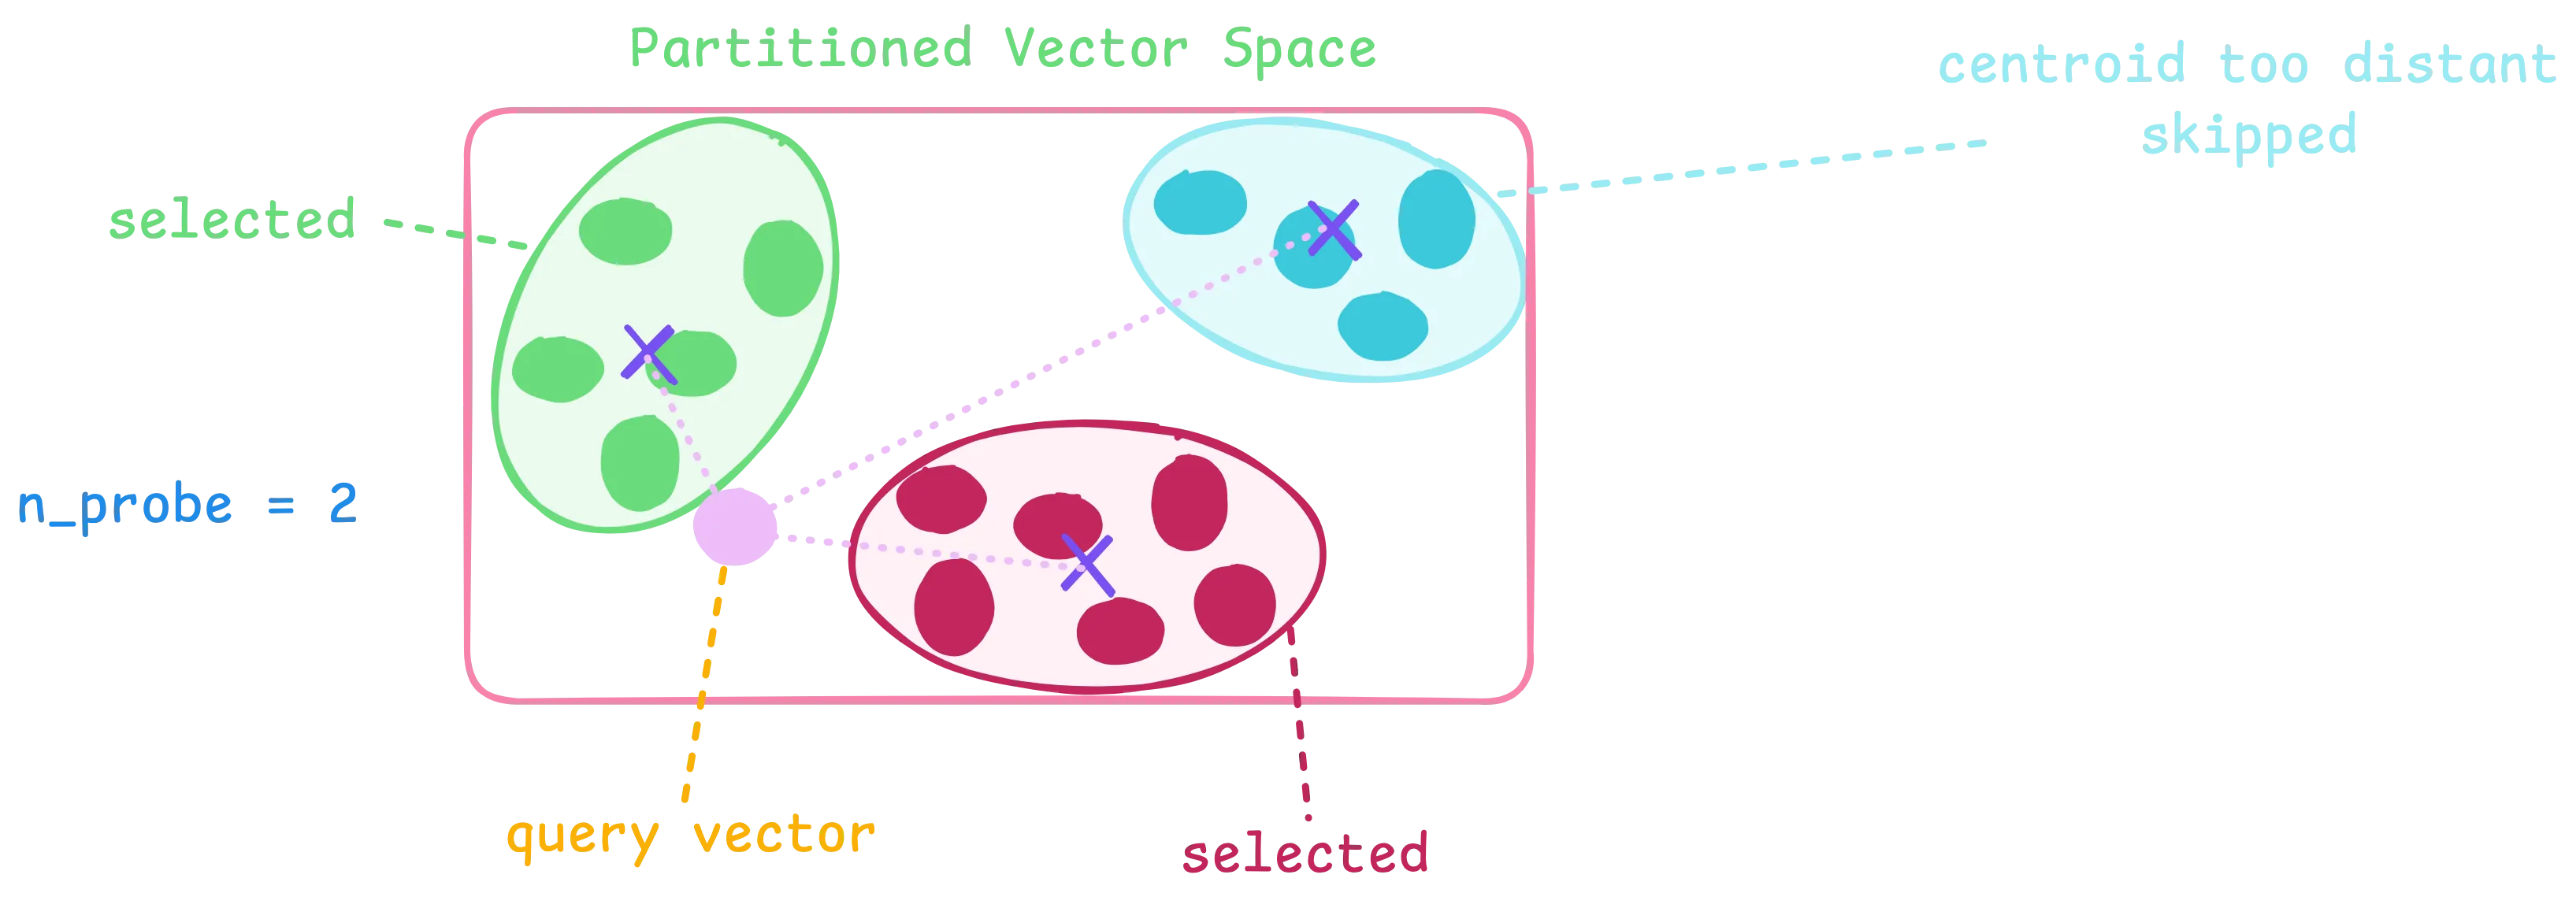
打个比方,这就像图书馆把书按学科分类。你想找一本机器学习相关的书,不需要翻遍整个图书馆,只要走到“计算机科学”那个书架附近,再在几个相关的架子上找就行了。当然,这种粗分类可能会让你错过一本被放错位置的好书,但效率提升是实打实的。
假设有以下文档集合: doc1: “Hello world” doc2: “Hello Akatshi” doc3: “Hello IVF”
构建IVF索引后,结果如下:
Hello: [doc1, doc2, doc3]
world: [doc1]
Akatshi: [doc2]
IVF: [doc3]
具体来说,IVF 有两个关键参数:
- nlist:聚类的数量。把空间划分成多少个区域。
- nprobe:查询时探测的聚类数量。也就是看几个最近的区域。
nlist 越大,每个区域里的数据越少,查询时如果只探测少数几个区域,速度就越快,但召回率可能下降,因为可能漏掉隔壁区域里真正最近的邻居。nprobe 越大,探测的区域越多,召回率越高,但计算量也上去了。
这就像在“快”和“准”之间架一杆秤,需要根据自己的业务需求找到那个平衡点。
在 Milvus 中主要有如下 IVF 索引类型,主要区别点在压缩率提升与精度平衡:
| 索引类型 | 构建参数 | 搜索参数 | 压缩技术 | 内存占用 | 召回率 |
|---|---|---|---|---|---|
| IVF_FLAT | nlist(范围[1,65536],默认128) | nprobe(范围[1,nlist],默认8)、max_empty_result_buckets(范围[1,65535],默认2) | 无压缩 | 最高(与原始数据相近) | 最优 |
| IVF_SQ8 | nlist(范围[1,65536],默认128) | nprobe(范围[1,nlist],默认8)、max_empty_result_buckets(范围[1,65535],默认2) | 标量量化(SQ),将FLOAT(4字节)转换为UINT8(1字节) | 中等(减少70-75%内存消耗) | 次之 |
| IVF_PQ | nlist(范围[1,65536],默认128)、m(乘积量化因子数,需满足dim mod m=0)、nbits(范围[1,64],默认8) | nprobe(范围[1,nlist],默认8)、max_empty_result_buckets(范围[1,65535],默认2) | 乘积量化(PQ),将高维向量分解为低维子向量并量化 | 最低 | 最低 |
IVF 的优缺点很鲜明:
- 优点:内存占用相对较小,因为只需要存聚类中心和每个区域的数据指针。构建速度也快,先跑个 K-Means 把数据分好类就行。查询时如果 nprobe 设得合理,速度非常可观。
- 缺点:召回率天生不如暴力搜索,因为总有漏网之鱼。而且聚类边界附近的数据很容易被误判——它可能离两个聚类中心都很近,但查询时只探测了其中一个,就错过了。另外,如果数据分布很不均匀,某些聚类会特别大,查询时即使只探测少数区域也可能碰到大块头,拖慢速度。
第一次用 IVF 的时候,我图省事把 nlist 设得很大,nprobe 设得很小,结果查询是快了,但召回率掉到 70% 多,业务上完全没法用。把 nprobe 调上去,速度慢得跟暴力搜索差不多。这参数调起来或许是一门玄学(
HNSW:多层图结构,像坐电梯一样快速逼近目标
HNSW 全称是 Hierarchical Navigable Small World。它的思想可以类比成跳表(Skip List),但用在了图结构上。
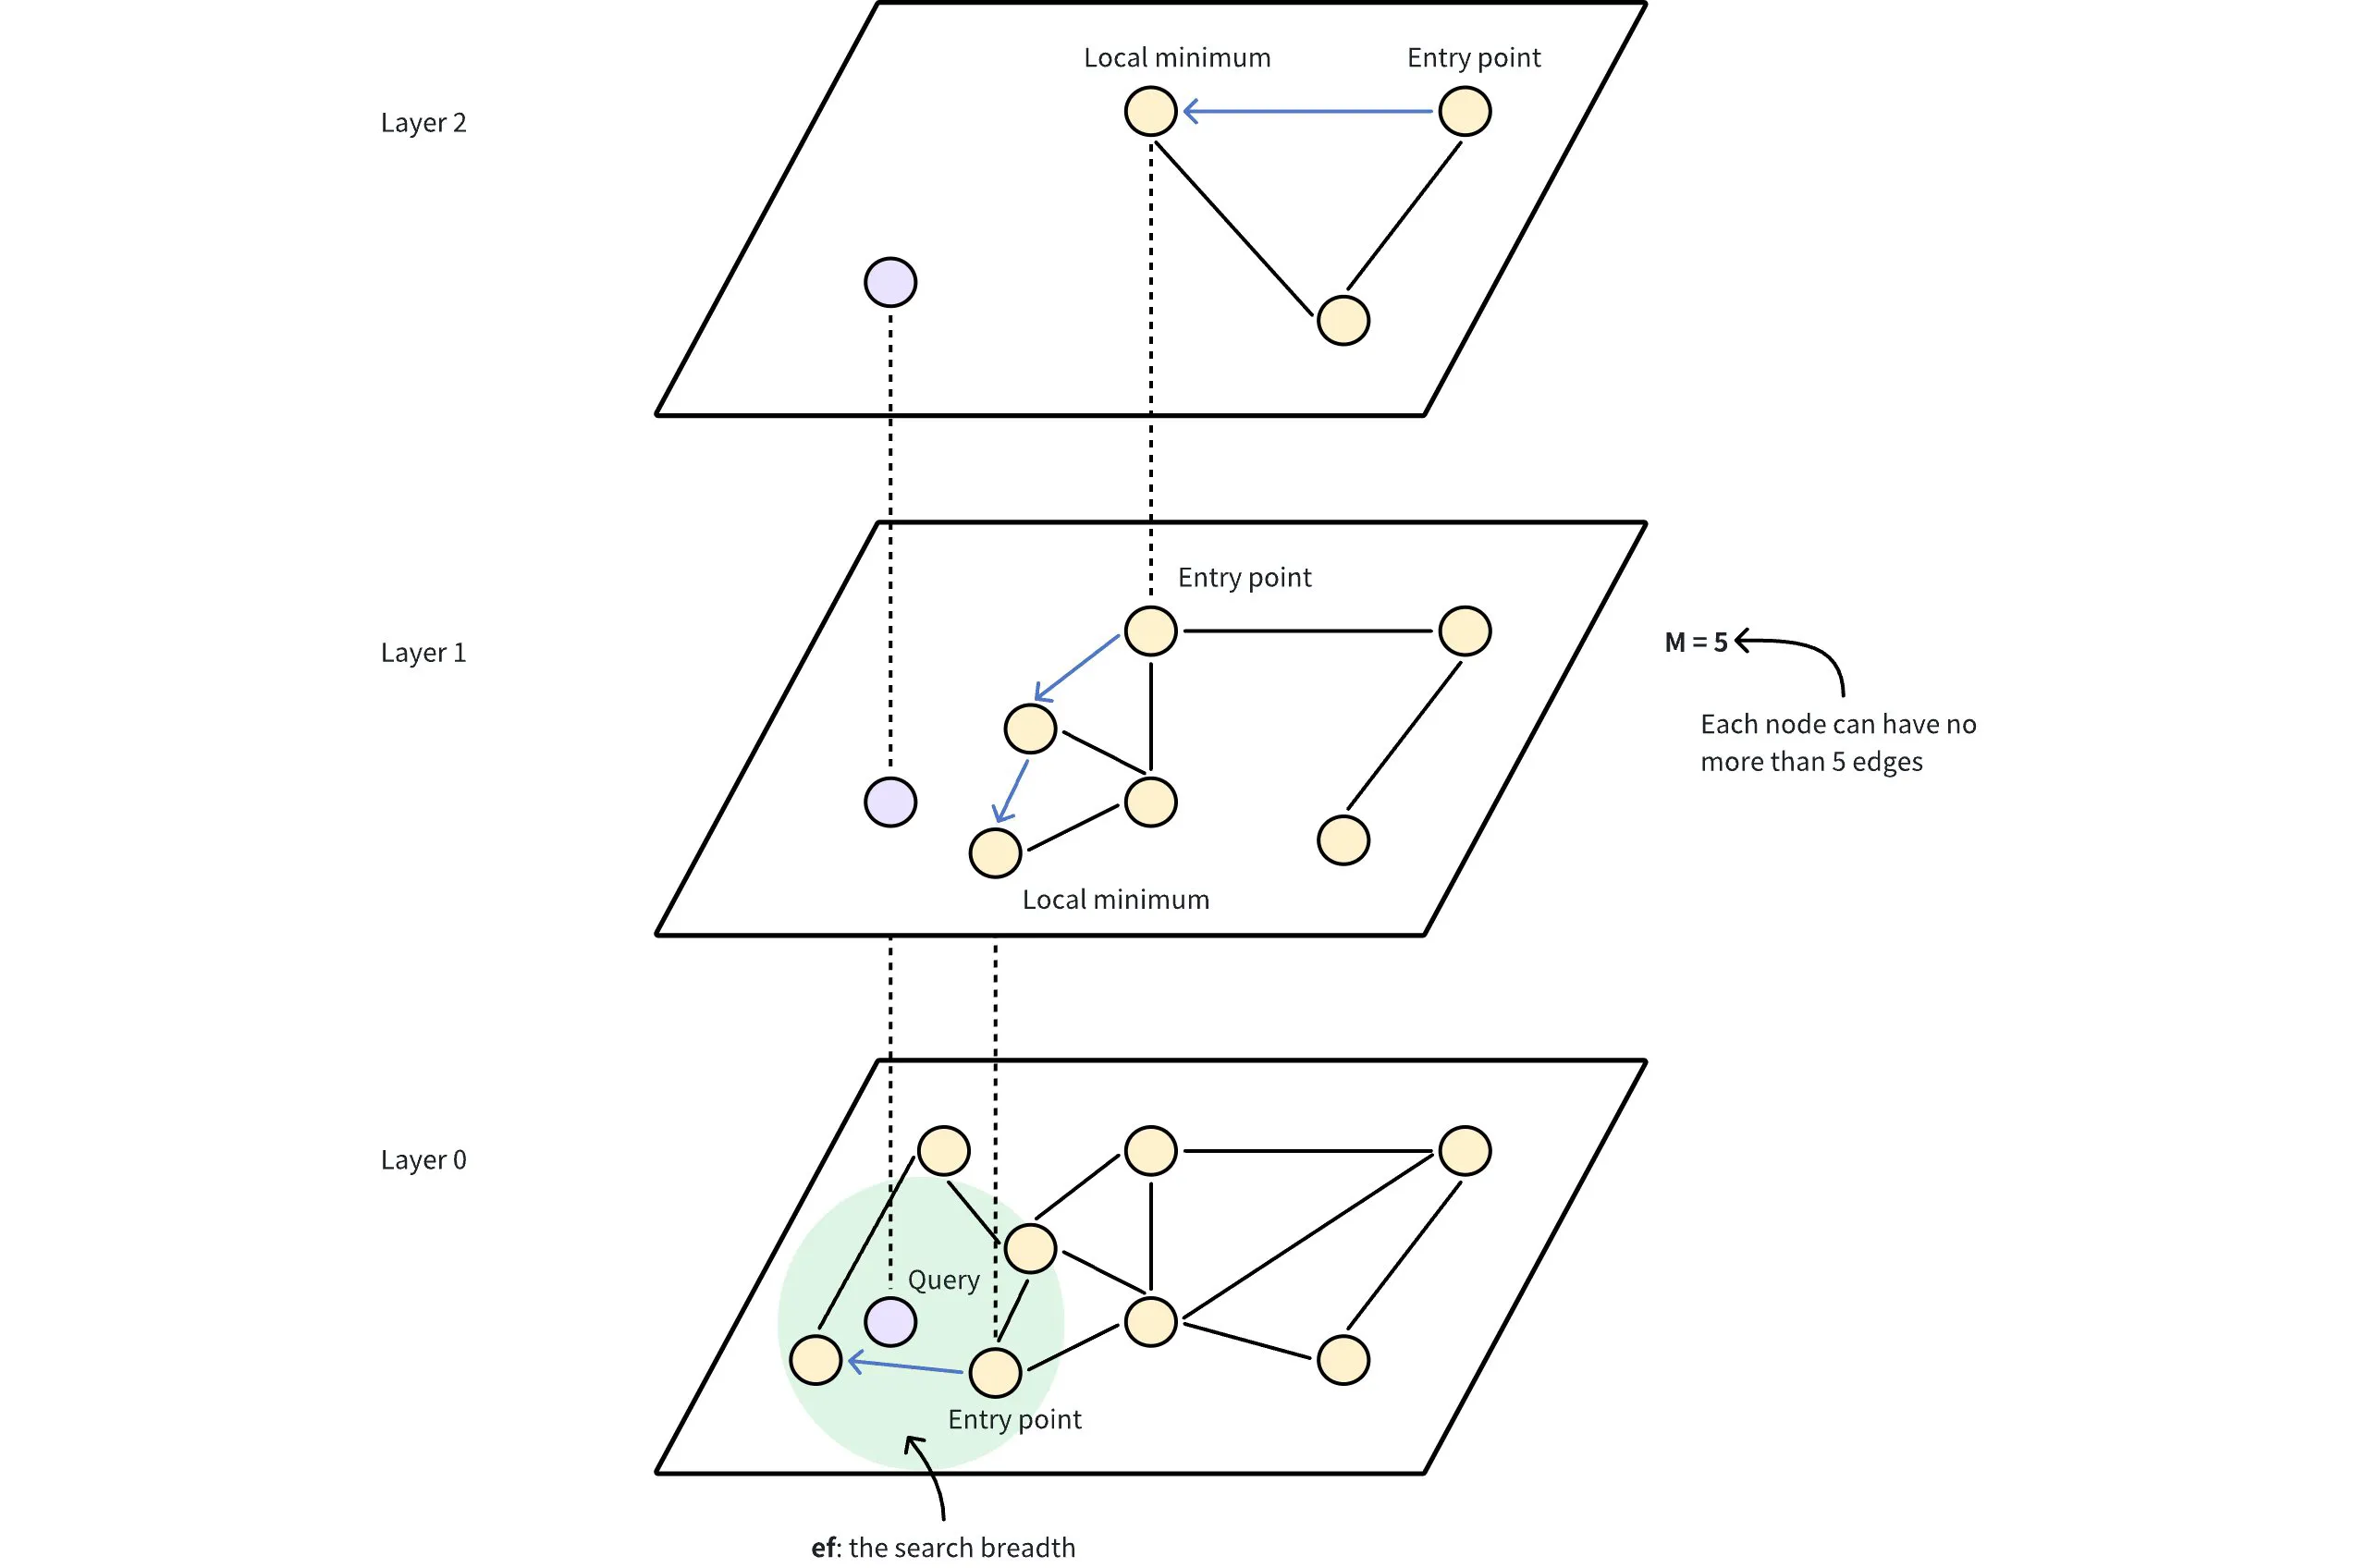 简单来说,HNSW 构建了一个多层的图。最底层包含所有数据点,每往上一层,节点数量就指数级减少,但节点之间的连接更“长”,能跨越大段距离。查询的时候,从最高层开始,沿着边做贪心搜索,快速跳到离目标近的区域;然后下降到下一层,再继续贪心搜索,逐步逼近。到了最底层,再在局部小范围内精细搜索。
这有点像你在一座陌生的城市找一家小店。先看大地图,开车上高速,快速接近目标区域;到了附近,换小路,慢慢找。HNSW 的层级设计就是让你在高层快速缩小范围,在低层保证精度。
HNSW 也有几个核心参数:
- M(连接度数):每个节点在图中连接的最大邻居数量。M 越大,图越稠密,搜索精度越高,但内存占用也越大,构建时间也变长。
- efConstruction(构建参数):构建索引时动态候选列表的大小。越大,构建的图质量越高,但构建越慢。
- efSearch(搜索参数):查询时动态候选列表的大小。越大,搜索越准,但查询越慢。
和 IVF 不同的是,HNSW 不需要预先划分聚类,它是靠图的结构来导航的。所以它天然适应数据分布的不均匀性,不会因为某个聚类太大而拖累查询。
HNSW 的优缺点:
- 优点:查询精度极高,很多时候可以接近暴力搜索的水平。查询速度在数据规模较大时依然很稳定,因为它只需要沿着图中的边跳转有限次数。另外它不依赖聚类,所以对数据分布不敏感。
- 缺点:内存占用大。因为要存储图结构,每个节点都要维护一组邻居指针,加上多层结构,内存开销通常是原始数据的数倍甚至更多。构建时间也比较长,尤其在大规模数据上,构建索引可能需要几个小时甚至更久。如果数据频繁增删,维护图结构也比较复杂。
用 HNSW 最直观的感受是:一旦建好索引,查询是够快,够准。建索引的过程让人十分折磨,尤其是几百万条数据的时候,看着进度条慢慢爬。而且内存吃得厉害,我 48G 的机器差点不够用。
LSH:局部敏感哈希,用哈希函数把相似向量撞进同一个桶
LSH 全称 Locality-Sensitive Hashing,局部敏感哈希。它的思路和前面几种完全不同:不靠聚类,也不靠图,而是靠哈希函数。
普通的哈希函数希望把不同的输入尽可能均匀地散开,哪怕输入只差一个字符,输出也天差地别。但局部敏感哈希反其道而行之:它设计出一类特殊的哈希函数,让相似的向量经过哈希后更有可能落到同一个桶里。这样查询的时候,只需要计算查询向量的哈希值,找到它所在的桶,然后只在这个桶(或者邻近的几个桶)里做精确比对。
打个比方,这就像把每个人按照大致身高分成几个组:150-160 一组,160-170 一组,等等。你想找一个 165 左右的人,直接去 160-170 那个组里找就行,不用满世界跑。虽然这个分组很粗糙,可能漏掉一些边界上的人,但效率极高。
LSH 的实现方式有很多种,常见的有基于随机投影、基于量化等。它的关键参数通常包括:
- 哈希函数的个数:使用的哈希函数越多,精度越高,但计算开销也越大。
- 哈希表的个数:可以构建多个哈希表来提高召回率,但内存占用也会增加。
- 桶的大小:每个桶里放多少数据,直接影响查询时精确比对的数量。
LSH 的优缺点:
- 优点:查询速度极快,时间复杂度可以做到近似 O(1) 到 O(log N)。内存占用相对较小,尤其是配合一些压缩技术后。适合超大规模、高维、对延迟极其敏感的场景。
- 缺点:召回率通常不如 HNSW 和 IVF,因为哈希分桶的边界效应很明显。参数调优比较复杂,而且对于不同距离度量(欧氏距离、余弦相似度、内积等),需要设计不同的哈希函数族。数据分布变化时,可能需要重新构建哈希表。
LSH 在工业界曾经风光过一阵,后来随着 HNSW 这类图方法的兴起,在一些场景下被替代了。但在超大规模、内存极度受限、或者对延迟要求极高的场景下,LSH 依然有自己的用武之地。
到底选哪个?
这些索引没有绝对的优劣,关键看你的约束条件是什么。我整理了一下自己的经验:
什么情况下选 FLAT:
- 数据量很小,比如几万条以内,暴力搜索完全能扛住。
- 对精度要求 100%,不能接受任何近似误差。
- 需要作为基准线,和其他索引的召回率做对比。
什么情况下选 IVF:
- 数据量很大,内存紧张。IVF 的内存占用比 HNSW 低不少。
- 对召回率要求不是特别苛刻,比如 95% 左右就能接受。
- 构建时间有限,需要快速上线。
- 数据分布比较均匀,或者你愿意花时间调 nlist 和 nprobe。
什么情况下选 HNSW:
- 对查询精度要求高,比如推荐系统、语义搜索,希望尽量接近暴力搜索的效果。
- 内存不是大问题,或者数据量中等(百万级以内)。
- 可以接受较长的构建时间,并且数据更新不频繁。
- 不想花太多时间调参,HNSW 的默认参数往往就能给出不错的效果。
什么情况下选 LSH:
- 数据规模超大,比如上亿条,内存极度紧张。
- 对查询延迟要求极高,比如毫秒级甚至更低。
- 可以接受一定程度的召回率损失,比如 90% 左右。
- 数据分布比较稳定,不需要频繁重建索引。
实际使用中会把不同的索引结合起来,如先做 IVF 粗筛,再做精确计算,或者用 PQ 压缩向量来降低内存。但单从 FLAT、IVF、HNSW 和 LSH 这几个基础索引来说,上面的判断基本够用。
调参的一点小建议
对HNSW,把 M 设成 16 或 32,efConstruction 设成 200 左右,efSearch 设成 100 或更高,然后跑一下测试集看召回率和延迟。HNSW 对参数不算特别敏感,默认值通常能拿到不错的结果。
IVF 的话,nlist 一般设置在 sqrt(N) 到 4*sqrt(N) 之间,比如 100 万数据,nlist 设 1000 到 4000。nprobe 从 10 开始往上调,观察召回率和延迟的变化。注意 nlist 太大或太小都不好,需要根据数据分布调整。
LSH 的调参相对麻烦,因为哈希函数的选择和参数设置跟数据分布、距离度量强相关。应该先从简单的随机投影 LSH 开始,逐渐增加哈希函数个数和哈希表个数,在召回率和内存之间找一个平衡点。如果效果不理想,再考虑换其他 LSH 变体。
最终参数要用你自己的数据和查询分布来评测。我这的参数只能参考,你的数据可能完全不一样。
总结
FLAT、IVF、HNSW 和 LSH 代表了四种不同的索引哲学:
- FLAT 是暴力搜索,精度满分但速度拉胯,只适合小数据量。
- IVF 是把空间提前划好格子,查询时只搜最近的格子,省内存、构建快。
- HNSW 是构建一张导航图,查询时沿着图快速逼近目标,精度高、查询稳。
- LSH 是用哈希函数把相似向量撞进同一个桶,速度极快,适合超大规模场景。
希望这篇分享能帮你在选索引时少走点弯路。如果你也在调这些参数,欢迎留言交流,我很好奇大家怎么在“快”和“准”之间做取舍。